

 资讯内容
/
研究亮点
识别脉冲型地震动的计算机视觉深度学习模型
发布时间: 2026-11-16 点击数量:181研究背景:
大量震害表明,近断层脉冲型地震动会对长周期工程结构造成严重破坏,识别这类地震动是保障结构安全的前提。其具有长周期、大幅值的波形特征以及低频能量相对集中的频谱特征,这启发了作者将脉冲型地震动识别任务转化为图像分类任务。深度学习技术,特别是计算机视觉领域的卷积神经网络(CNN)与视觉Transformer模型,为实现这一思路提供了技术可行性。然而,在实际应用中,此类模型面临两大核心瓶颈。其一,数据层面的挑战。脉冲型地震动记录稀缺且样本分布严重失衡,限制了模型学习有效特征的能力,同时,何种数据特征最有利于模型识别尚不明确。其二,模型层面的挑战。复杂深度学习模型易在小样本上过拟合,而简单模型又难以捕捉复杂的脉冲特征。纯数据驱动的深度学习模型会过度关注信号特征,模型决策过程缺乏物理可解释性。明确数据特征与模型架构对模型性能的影响,并有效融入物理约束,是提升深度学习模型在脉冲型地震动识别中泛化能力与适用性的关键挑战。
研究方法及结果:
针对上述问题,本研究建立了一套识别与优化框架,旨在探究不同视觉深度学习模型与多数据特征在脉冲型地震动识别任务中的适用性。如图1所示,在模型层面,提出了两种架构:
(1)增强型CNN(CNN+SAM):在传统CNN中嵌入自注意力机制(SAM)以强化对脉冲特征的聚焦,并引入Focal Loss函数缓解样本不平衡;将矩震级和断层距作为物理约束,构建物理约束增强型CNN,以增强模型可解释性。结果表明,数据特征、数据集规模与模型架构的耦合作用显著影响模型性能,物理参数的引入显著降低了模型对输入数据质量的依赖,尤其对双输入图像的精度提升显著(图2)。
(2)视觉Transformer模型:采用Vision Transformer(ViT)和Swin Transformer(SwinT),利用其全局建模能力进行对比。结果表明,SwinT在单输入图像上的表现与CNN+SAM相当且优于ViT;在双输入任务中,ViT表现优于SwinT,且两者均优于CNN+SAM;物理约束能有效辅助深度学习模型排除伪脉冲记录干扰(图3)。
研究表明,物理约束的选取须考虑其与输入数据特征的相互作用。若物理约束参数本身与数据特征关联模糊,则可能引入额外的不确定性,制约模型性能的提升。在计算资源受限的场景下,单输入时频图+物理约束增强型CNN为脉冲型地震动识别任务的最优策略。
该成果发表于国际权威期刊《Computer-Aided Civil and Infrastructure Engineering》(Lu Han, Zhengru Tao*). Deep learning for computer vision in pulse-like ground motion identification. Computer-aided Civil and Infrastructure Engineering, 2025, 40(22): 3548-3563.
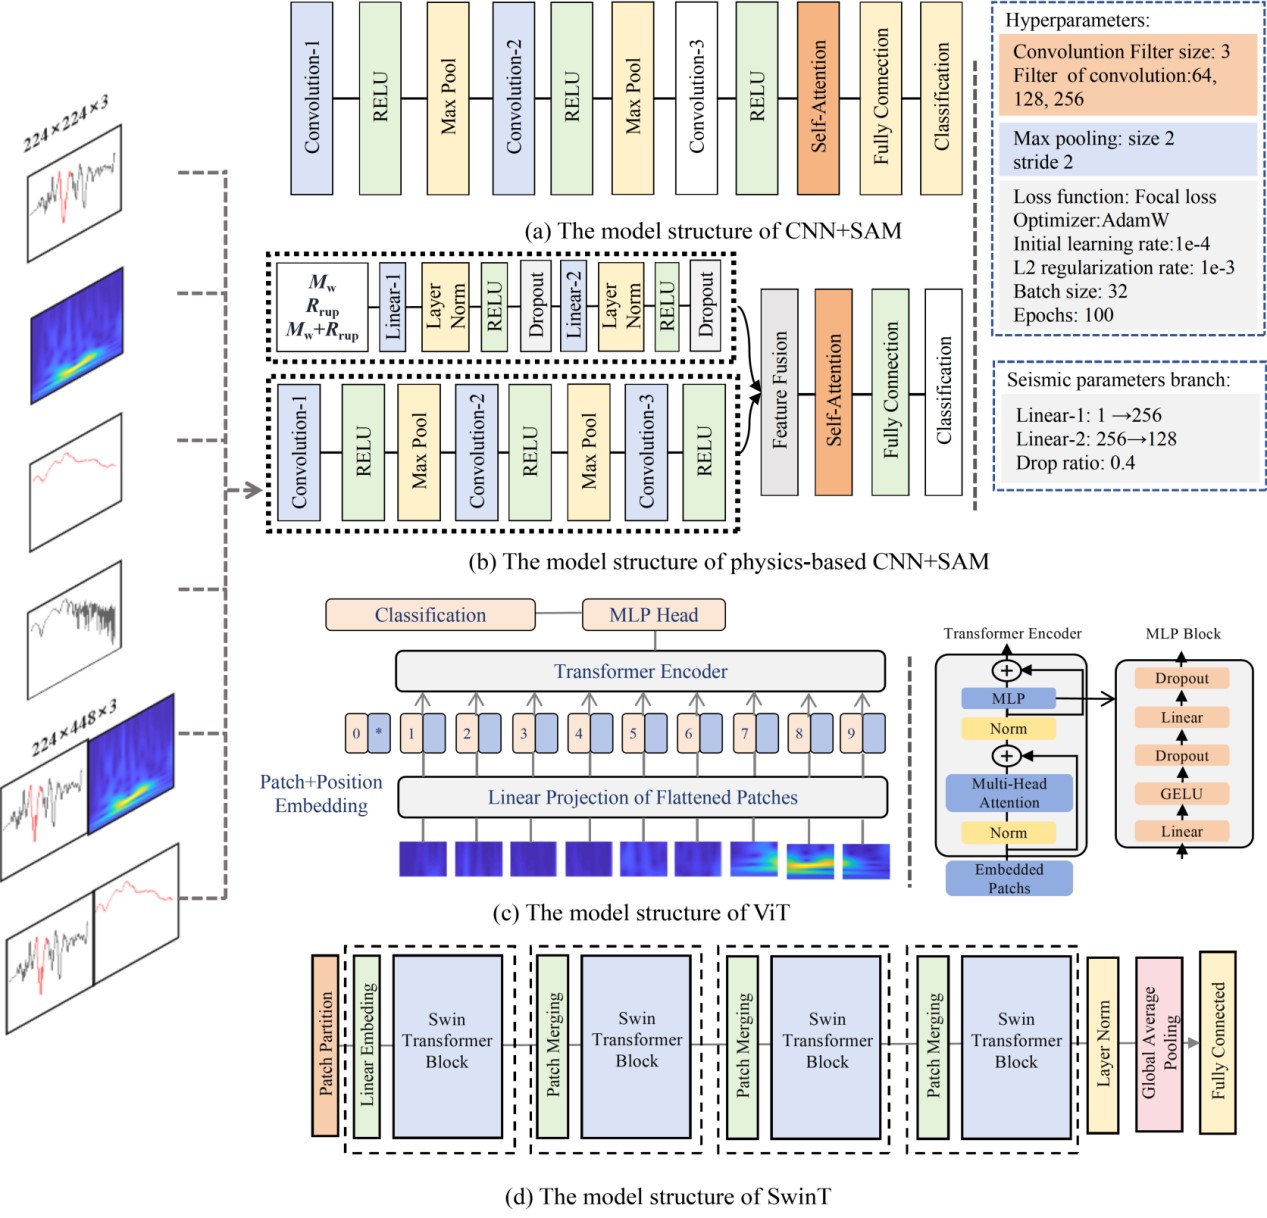
图1 六类图像数据集及与两类视觉深度学习架构
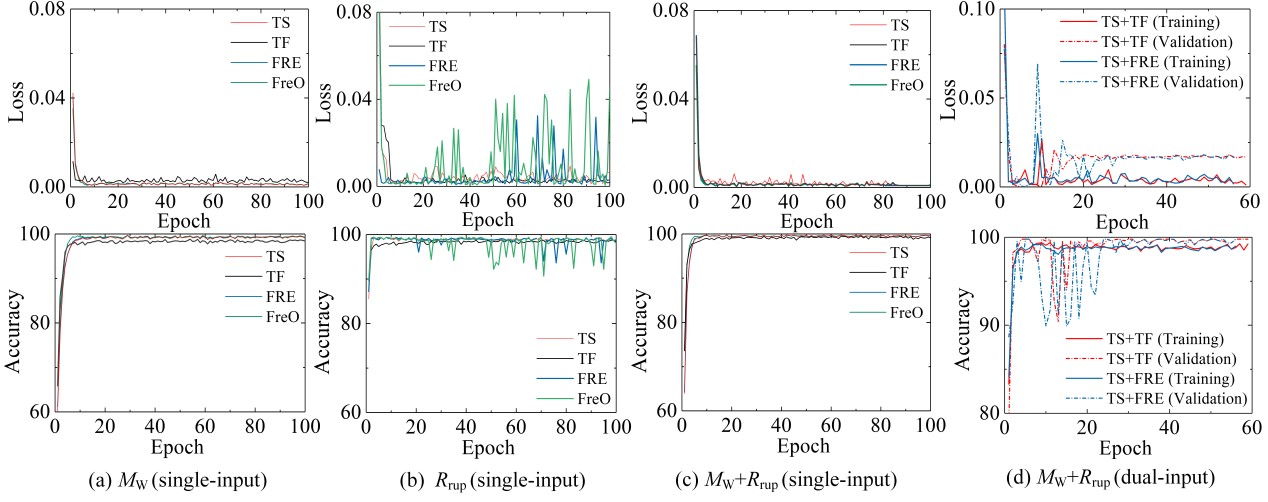
图2 物理约束的增强CNN的训练损失和准确率曲线
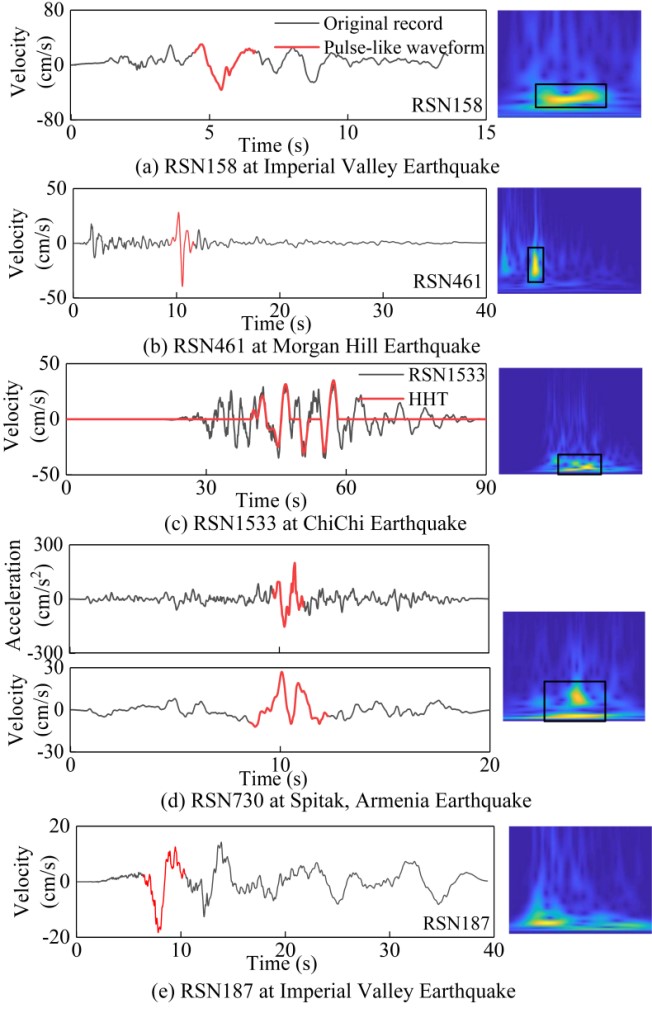
图3 速度时程和Morlet时频图
上一篇
下一篇


